最長共通接頭辞(Longest Common Prefix)を自分で考えた実装でもLeetCodeで0msAcceptだった話
どうも、まあるです。ヤホ(๑>◡<๑)
今回はアルゴリズムが苦手すぎるので簡単な問題から理解していこうと思いLeetcodeのeasy問題から挑戦してみました。以下問題のリンクです。
こちらタイトルの通りLongest Common Prefix(=複数の言葉の全てで最初から一致する最長の部分)を求める問題になっています。
問題で与えられたのはlist型の1個だけです。
例えばlist = [july, jupyter, june]とあったら、全ての言葉で先頭から一致する部分を取り出すので答えは"ju"となります。
最長共通接頭辞という7字の漢字だけで理解できるようにした日本人、すごい超えてこわいですね😅
で、私ほんとに一般的な二分木とか再帰とかのアルゴリズムすらもまっっっっったく覚えられないので、当たり前のように思いつく実装で書きました。
    class Solution(object):
        def longestCommonPrefix(self, strs):
            ans = ""
            a = min(strs)
            f = True
            for s in range(len(a)):
                check = ans+a[s]
                for i in strs:
                    if not i.startswith(check):
                        f = False
                if f:
                    ans+=a[s]
                else:
                    break
            return ans
これです。変数がわかりにくいaとかfだけの単語になっているのはお許しを、、、。
早くなる方法を考えた時に、基準にする単語をリストの中で一番短い言葉にしちゃえばいいのかなということでaを設定してます。fはflagの意味で基準にする言葉と違う文字が出てきたら即座に終了するために設けました。
二重ループなのですが2個目のfor文内でfalse受け取ったらすぐ終了できるよう1個目のfor文の最後にfがTrueかFalseかチェックしてFalseならbreakで終わらせてるという感じです。
エイヤー(><)とsubmitしたところこれが0msのところだったので驚きました!!
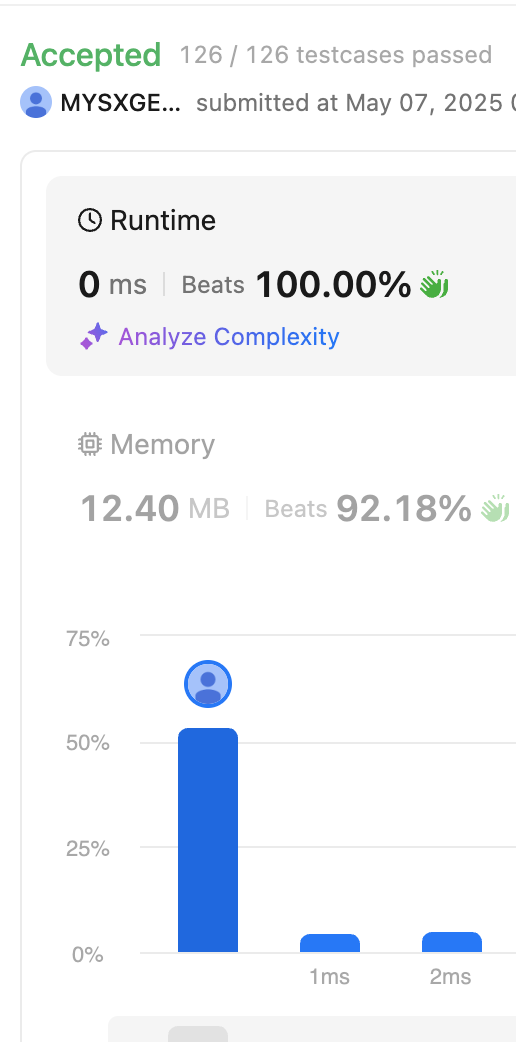
これがなぜ最長共通接頭辞を求める一般的なアルゴリズムと同じくらいの速さだったのか不思議がりました。
結論として
1.仮の接頭辞を決め一つでも異なればすぐに処理を終了している
2.startswith関数がC実装されていてpythonでも早い処理になっている
ことが理由かなと思います。
ですが1番の大きな理由はやはり、LeetCodeが入力サイズ制限しててあんま差が出ないから〜〜〜〜〜!あと極論文字を一つずつ見ていくしかないので計算量Oは変わらないってね笑
でも、自分の成長を感じられたし、少しずつ前に進む楽しさを知って何かにハマっていくことは全然あると思うので素直に喜んでEasy解き進めていけたらなと思います!
以上まあるでした!バイバイ👋😆
